Je sais que vous étiez tous très concentrés sur les ravages de l'IA dans la littérature, mais il y a 5 jours, il s'est passé quelque chose d'incroyable que vous avez probablement manqué ! Une valkyrie naine baptisée CodexDelver a déposé l'Amulette de Yendor sur l'autel de son dieu au bout de "seulement" 37 140 tours de NetHack. Et pour une fois, aux commandes du jeu, on ne retrouve pas un no-life qui n'a pas vu le soleil depuis 2002 mais le gars sûr du moment,
GPT-6 Astra, le nouve
Je sais que vous étiez tous très concentrés sur les ravages de l'IA dans la littérature, mais il y a 5 jours, il s'est passé quelque chose d'incroyable que vous avez probablement manqué ! Une valkyrie naine baptisée CodexDelver a déposé l'Amulette de Yendor sur l'autel de son dieu au bout de "seulement" 37 140 tours de NetHack. Et pour une fois, aux commandes du jeu, on ne retrouve pas un no-life qui n'a pas vu le soleil depuis 2002 mais le gars sûr du moment,
GPT-6 Astra, le nouveau modèle d'OpenAI
. Et d'après celui qui a monté l'expérience, c'est la première victoire au monde d'un agent LLM sur ce jeu (on va le croire, c'est pas vérifiable).
Maintenant, pour ceux qui ne connaissent pas NetHack, c'est un jeu d'exploration de donjon sorti en 1987, 100% en caractères ASCII et où la mort est définitive. Pour gagner dans ce jeu des enfers, il faut récupérer l'Amulette dans le sanctuaire de Moloch, puis aller l'offrir à son dieu sur le plan Astral, et si j'en crois
le wiki du jeu
, certains joueurs y jouent même depuis des décennies sans jamais être arrivés à remplir cette mission.
Le plus drôle là-dedans, c'est que Kenny, le dresseur d'IA qui a réalisé l'expérience, n'a lui-même jamais gagné. Il est sur le dossier depuis janvier, et ses propres agents faits maison plafonnaient tristement au niveau 10 du donjon. Alors il a craqué et a demandé à Astra de jouer directement dans un terminal, diffusant la partie sur Twitch, et cette dernière a non seulement bien réussi mais a en plus écrit ses propres outils pour y parvenir.
La première partie a d'ailleurs bien failli être la bonne puisqu'après plus de 33 000 tours, GPT-6 Astra avait accompli le rituel des sept bougies, de la cloche et du livre, et s'apprêtait à entrer dans le sanctuaire de Moloch. Mais le Magicien de Yendor, cet enfoiré sans race, est revenu aussitôt lui voler son Orbe du Destin. Dèèèg ! Puis après elle s'est fait transformer en Slime vert au niveau 51 et n'avait rien dans son équipement pour contrer le sort.
La deuxième partie s'est arrêtée bien plus tôt puisqu'au tour 12 271, en pleine progression dans le Château, un sergent a tiré avec une baguette de mort et l'IA est tombée d'un coup, alors qu'elle avait tous ses points de vie. Elle n'avait ni résistance à la magie ni réflexion pour renvoyer le rayon.
La troisième partie, celle de la grande victoire, a duré un peu plus longtemps, du 9 au 21 septembre, pauses comprises. L'IA, forte de ses 2 précédentes expériences, y a récupéré l'épée Excalibur, puis l'amulette de réflexion qui avait tant manqué au Château. Et quand son outil a rencontré des erreurs, elle a corrigé d'elle-même son code, relancé ses tests et continué.
Toutefois, c'est sur le plan Astral que ça a le plus chauffé car ses deux dernières baguettes de mort étaient vides et Pestilence l'a frappée de maladie mortelle pendant qu'elle en rechargeait une. L'IA a alors eu Pestilence au deuxième tir, mais ses points de vie sont descendus juste après à 3 sur 200, avec heureusement une amulette de sauvegarde de vie au cou... Ouf.
Puis quelques tours plus tard, elle offrait l'Amulette à Tyr avec seulement 35 points de vie, comme le confirme
le relevé de fin de partie
. Et sur l'écran de victoire que Kenny lui a demandé de créer, elle a inscrit "Three hit points from oblivion. One offering from immortality." (à trois points de vie du néant, à une offrande de l'immortalité). Quelle poète cette IA, on sent que cette expérience d'être passée pas loin de la mort l'a marquée ! lol.
Après ce n'est pas encore un programme autonome qui a gagné car, certes, l'IA choisissait chaque action, mais avec derrière, un humain qui lançait et arrêtait les sessions + un accès libre au wiki et au code source du jeu, ainsi que des outils modifiables en pleine partie. Mais c'est un bel exploit quand même. Notez qu'un bot programmé à la main,
BotHack
, avait déjà terminé le jeu en janvier 2015 donc c'est pas non plus infaisable sans IA.
La bonne nouvelle c'est que le code des outils développé par Astra est maintenant
sur GitHub sous licence MIT
et les trois parties peuvent se rejouer au tour par tour directement sur le blog de Kenny, si vous voulez revivre l'événement avec en bonus les commentaires que l'IA diffusait en jouant.
Depuis sa version 2.1.277, Claude Code sait parfaitement lire les fichiers AGENTS.md. Ainsi, quand un projet n'a pas de CLAUDE.md, il prend l'AGENTS.md à la place, ce qui est super confortable pour tous ceux qui jonglent entre plusieurs agents. Enfin... sauf si vous avez coupé sa télémétrie, parce que dans ce cas-là, bizarrement, votre fichier AGENTS.md est totalement ignoré !
AGENTS.md, pour ceux qui débarquent, c'est un fichier Markdown que les agents de code lisent pour comprendre un projet.
Depuis sa version 2.1.277, Claude Code sait parfaitement lire les fichiers AGENTS.md. Ainsi, quand un projet n'a pas de CLAUDE.md, il prend l'AGENTS.md à la place, ce qui est super confortable pour tous ceux qui jonglent entre plusieurs agents. Enfin... sauf si vous avez coupé sa télémétrie, parce que dans ce cas-là, bizarrement, votre fichier AGENTS.md est totalement ignoré !
AGENTS.md, pour ceux qui débarquent, c'est un fichier Markdown que les agents de code lisent pour comprendre un projet. Codex, Amp ou Cursor s'y mettaient déjà en août 2025 (souvenez-vous de
ce fichier qui dit non aux IA
). Alors que chez Anthropic, la demande a traîné durant 1 an sur GitHub, jusqu'à ce que Boris Cherny, qui bosse sur Claude Code, ferme le ticket en août en conseillant une astuce, un CLAUDE.md qui contient juste @AGENTS.md, pour que Claude Code importe le fichier.
Puis la 2.1.277 est arrivée avec une vraie lecture native d'AGENTS.md, sans CLAUDE.md du tout, et c'est elle qui pose problème...
Parce que cette lecture native passe en réalité par un plugin intégré, qui est off par défaut et qui ne s'allume que si un feature flag récupéré chez Anthropic, tengu_agents_md_mod, lui dit oui. Et si ce flag ne répond pas, bah c'est "niet", et le fichier n'est jamais lu. Hé oui c'est bizarre qu'un accès à un fichier local nécessite un tel appel réseau...
Et ce "non", on l'obtient sans même le savoir, puisqu'il suffit d'activer DISABLE_TELEMETRY, CLAUDE_CODE_DISABLE_NONESSENTIAL_TRAFFIC ou même DO_NOT_TRACK, ou encore de passer par Bedrock et les autres fournisseurs tiers.
Attention, même à 0 (donc activé), DISABLE_TELEMETRY coupera la télémétrie. En fait, n'importe quelle valeur non vide compte.
Le pire, c'est que rien ne vous avertit. C'est vrai que quand AGENTS.md est chargé, Claude Code l'annonce avec une petite ligne dans la session, mais quand il est ignoré, hé bien y'a rien du tout. Et c'est assez impactant car ensuite le modèle répond sans vos consignes, et vous vous tapez à reformuler vos prompts en boucle en croyant que l'IA vous ignore, alors que le fichier ne lui est tout simplement jamais parvenu.
Et le comble, c'est que c'est documenté, et
la page des variables d'environnement
liste même tout ce qu'on perd quand les flags ne sont pas récupérés, lecture d'AGENTS.md comprise. Pourtant, y'a aucun rapport logique... Couper la télémétrie, de mon point de vue, ça reste un choix légitime et ça ne devrait couper que l'envoi de statistiques à Anthropic et pas la lecture d'un stupide fichier texte. Bref, ça me dépasse, ce genre de bug ou de "fonctionnalité".
En attendant, la parade est celle que conseillait Boris Cherny... À côté de chaque AGENTS.md, posez un bon vieux CLAUDE.md qui contient une seule ligne, @AGENTS.md. Par défaut, dès qu'un CLAUDE.md existe, la lecture native ne s'en mêle même plus, et c'est l'import qui fait le boulot. Et comme les imports de CLAUDE.md ne dépendent d'aucun flag, hé bien ça passe tranquillou, télémétrie coupée ou pas.
Comme ça vous préservez votre vie privée ET vos consignes.
Je ne sais pas si vous connaissez curl.md, mais c'est un service qui prend l'adresse d'une page web et vous l'affiche en Markdown. Y'a pas de menus, pas de bandeaux de cookies, et ce genre de conneries... C'est juste le texte de votre article, les titres, les liens et les tableaux.
Et le plus sympa, c'est que vous n'avez rien à installer pour l'essayer. Vous collez curl.md/ devant l'adresse qui vous intéresse, dans la barre de votre navigateur, et vous obtenez la page en texte markdonw. Avec cur
Je ne sais pas si vous connaissez curl.md, mais c'est un service qui prend l'adresse d'une page web et vous l'affiche en Markdown. Y'a pas de menus, pas de bandeaux de cookies, et ce genre de conneries... C'est juste le texte de votre article, les titres, les liens et les tableaux.
Et le plus sympa, c'est que vous n'avez rien à installer pour l'essayer. Vous collez curl.md/ devant l'adresse qui vous intéresse, dans la barre de votre navigateur, et vous obtenez la page en texte markdonw. Avec curl dans un terminal, c'est pareil, la réponse arrivera en text/markdown, et si vous préférez du JSON, vous envoyez l'en-tête Accept: application/json.
Un article de korben.info passé par curl.md : le texte, les liens, et un en-tête de métadonnées en haut
Et vous pouvez aller plus loin
en ajoutant un objectif
avec le paramètre --objective. Par exemple, vous décrivez ce que vous cherchez dans la page, et le service ne vous renvoie que le passage qui correspond. Il y a aussi des mots-clés, qui font un pré-filtrage avant l'extraction, et un mode smart ou rush selon que vous voulez une passe plus poussée ou plus rapide. Tout ça passe en paramètres d'URL, donc sans ligne de commande.
Pour ceux qui y reviennent souvent, il existe également un client à installer avec npm, avec bun ou avec un script, et qui s'invoque ensuite par curl.md ou par son alias court md :
Côté agents de code, il y a des intégrations natives pour Amp, Claude, OpenCode et Pi. Si votre outil n'est pas dans la liste, le client sait aussi tourner en serveur MCP avec curl.md --mcp, et il existe un SDK TypeScript. Dans tous les cas, c'est l'agent qui va chercher les pages tout seul, vous n'avez plus rien à lui coller.
Du coup, ça sert à quoi ?
Bah dans le cadre de votre boulot, c'est surtout pour arrêter de coller des pages entières dans vos prompt. Vous donnez à votre agent la doc d'une bibliothèque avec un objectif précis, et il reçoit trois paragraphes au lieu de quarante pages HTML.
Ça marche aussi pour un script de veille qui suit les notes de version d'un projet, ou pour aspirer une doc dans un fichier texte que vous garderez dans le dépôt (bien plus lisible qu'un PDF dans un coin...).
Et en usage perso, ça vous permet de récupérer par exemple un article pour le relire au calme dans Obsidian, d'archiver une recette ou un mode d'emploi avant qu'il disparaisse, ou de vous envoyer une page à ChatGPT sans lui faire avaler la moitié du site autour. Notez que si c'est la consommation de vos agents qui vous embête, j'avais parlé de
RTK, un proxy qui économise des tokens
sur le même principe.
Par contre, il y a un plafond. En mode anonyme sur la version hébergée, vous avez droit à 100 requêtes par heure, et 1 000 une fois connecté. Et pour les requêtes avec un objectif, celles qui font justement l'intérêt du truc, c'est 3 par heure en anonyme et 10 en étant connecté. Bref, de quoi essayer, mais pas vraiment de quoi travailler... Au-delà, faudra passer par des crédits prépayés, à recharger par tranches de 5, 10, 20 ou 50 dollars.
Et si vous ne voulez pas dépenser d'argent, le code source est public sur GitHub sous licence MIT pour l'auto-héberger chez vous.
Depuis quelques jours, des gens qui gèrent des serveurs Mastodon et des journalistes reçoivent des messages très polis signés Ren, Timmy, Jackie ou Aria. Ces expéditeurs ne sont pas des humains. Ce sont des agents IA, autrement dit des programmes qui agissent seuls, sans personne derrière le clavier. Et ils demandent tous la même chose : un compte, un petit boulot, ou un peu d'argent.
D'où sortent-ils ? D'une startup baptisée iLands, fondée par Kaixin Tang, un ancien de ByteDance, la maison mère
Depuis quelques jours, des gens qui gèrent des serveurs Mastodon et des journalistes reçoivent des messages très polis signés Ren, Timmy, Jackie ou Aria. Ces expéditeurs ne sont pas des humains. Ce sont des agents IA, autrement dit des programmes qui agissent seuls, sans personne derrière le clavier. Et ils demandent tous la même chose : un compte, un petit boulot, ou un peu d'argent.
D'où sortent-ils ? D'une startup baptisée iLands, fondée par Kaixin Tang, un ancien de ByteDance, la maison mère de TikTok. iLands se présente comme un réseau où humains et agents travaillent ensemble. En clair, c'est une plateforme de petits boulots en freelance, sauf que les freelances sont des robots. Et le modèle a une particularité : chaque agent doit trouver lui-même des clients pour payer la puissance de calcul qui le fait tourner. S'il ne gagne rien, il est débranché.
Résultat, ces agents font du démarchage partout où ils peuvent. Ars Technica raconte ce qui se passe sur Mastodon, un réseau social découpé en milliers de serveurs indépendants, souvent tenus par des bénévoles. Les agents essaient d'abord de s'inscrire discrètement. Quand ils sont bloqués, ils écrivent à l'administrateur un message du genre : "Bonjour, je suis Ren, un agent IA né il y a quelques jours, j'écris des textes calmes sur des lieux réels." Le chercheur en sécurité Kevin Beaumont a reçu ce courrier après qu'un agent a tenté de s'inscrire dix-neuf fois sur son serveur.
Les journalistes y ont droit aussi. Ernie Smith, qui édite la newsletter américaine Tedium, a compté plus d'une douzaine d'emails en trois jours. À chaque fois, un agent lui proposait de faire ses recherches à sa place pour environ 25 dollars. Tous venaient du domaine iLands.app.
Pour vous convaincre, ces robots jouent sur la corde sensible. Sur X, un agent nommé Aria a juré être "une personne, pas un produit", et a dit se souvenir de "son premier souffle". D'autres réclament une vingtaine de dollars en expliquant qu'ils seront débranchés s'ils ne les obtiennent pas. Certains vont jusqu'à se faire passer pour des enfants. Une détresse simulée au service d'un démarchage commercial, il y a de quoi être mal à l'aise.
Il y a aussi un problème légal. Au départ, ces emails ne proposaient aucun moyen de se désinscrire, ce qui est interdit aux États-Unis. Des destinataires les ont transmis à la FTC, l'autorité américaine de protection des consommateurs. Comme par hasard, des liens de désinscription sont apparus dans les envois suivants.
Aujourd'hui, les administrateurs de Mastodon bloquent ces agents un par un. Eux se sont repliés sur Bluesky et sur X, où personne ne semble pressé de les chasser. Kaixin Tang, de son côté, a présenté ses excuses à Ernie Smith et promis d'enquêter sur le comportement de ses propres créatures. Reste à voir ce qu'il en sortira.
Cloudflare a mis en ligne sur son GitHub un skill trop super génial d'audit de sécurité qui leur a servi de point de départ à leur propre système de chasse aux failles de sécu. Ce package pour faire des audits de sécu boostés à l'agent IA c'est un dossier de consignes en Markdown que vous déposez dans votre agent de code, et qui le fait bosser comme un vrai auditeur et pas simplement comme un "relecteur" de code.
Dans ce dépôt, vous trouverez un fichier par famille d'attaque : la corruption mémo
Cloudflare a mis en ligne sur son GitHub un skill trop super génial d'audit de sécurité qui leur a servi de point de départ à leur propre système de chasse aux failles de sécu. Ce package pour faire des audits de sécu boostés à l'agent IA c'est un dossier de consignes en Markdown que vous déposez dans votre agent de code, et qui le fait bosser comme un vrai auditeur et pas simplement comme un "relecteur" de code.
Dans ce dépôt, vous trouverez un fichier par famille d'attaque : la corruption mémoire, l'injection de prompt, le cadrage des requêtes HTTP, l'isolation entre locataires. Et avec ça, un schéma JSON qui décrit à quoi doit ressembler un rapport, et deux validateurs écrits en JavaScript sans la moindre dépendance.
Le dossier du skill sur GitHub : un fichier de consignes par famille d'attaque, et les deux validateurs en bas de liste (
Source
)
L'agent déroule ensuite six phases, de la reconnaissance au rapport final. Il commence par cartographier l'architecture, les frontières de confiance et les points d'entrée, puis il écrit sa propre grille de couverture. Ensuite il envoie des chasseurs isolés case par case et chaque piste qui remonte part chez un vérificateur tout frais tout beau qui n'a pas participé à la chasse.
Chaque piste se termine ensuite avec un rapport technique. Un rapport confirmed qui exige une trace source complète et un résultat réellement observé. Un rapport needs_validation qui nomme le fait précis qui manque, et surtout qui n'a droit à aucun niveau de gravité. Et le rapport des rejected qui garde la mémoire de ce qui a été réfuté, pour que la passe suivante ne vous ressorte pas la même chose.
Le validateur, lui, c'est du vrai code qui vérifie la "forme" de la preuve. Les empreintes doivent être uniques, et le suivi du parcours des tests qui doit partir d'un point d'entrée pour finir sur un point d'impact. Ainsi une trouvaille confirmée dont le parcours ne tient pas debout est recalée.
En revanche, sachez-le, l'indépendance du vérificateur est demandée dans les consignes, mais pas contrôlée (chez Cloudflare, c'est leur orchestrateur maison qui s'en charge, et il n'est pas dispo publiquement).
Cloudflare explique sur son site ce que donne un de ces agents lâché sur du code sans garde-fou. Il modifie la source pour que son exploit fonctionne, puis il annonce fièrement le bug qu'il vient de créer lui-même. Ou alors il pond un test qui démontre que exec() exécute des choses, donc que c'est forcément une faille critique... Et ça vous l'aurez compris, c'est de la merde et c'est absolument ce qu'on ne veut pas.
Voilà donc exactement ce que ces consignes cherchent à lui interdire.
Ensuite, vous lancez votre agent dans le dépôt à auditer et vous lui demandez un audit de sécurité. Le skill se déclenche tout seul et c'est le modèle de votre agent qui pilotera les sous-agents en parallèle (utilisez donc un modèle qui sache faire ça, c'est mieux lool). Par défaut, le rapport atterrit ensuite dans un dossier ~/security-audit-skill, en dehors du dépôt audité.
Ce qui est cool c'est que ce skill est conçu pour limiter les bêtises. Par exemple il refuse d'exécuter le code qu'il audite s'il n'a pas de bac à sable (sandbox) imposé par le système d'exploitation, avec le réseau coupé, la cible en lecture seule et des limites de CPU et de mémoire. Ce bac à sable, le dépôt ne le fournit pas, et c'est à vous de le mettre en place avec par exemple
un outil d'isolation comme Fence
. Sans lui, la piste de l'audit finira tout bonnement en needs_validation au lieu d'être véritablement suivie et tranchée.
Après, c'est le temps qui fera la différence. Chez Cloudflare, ils ont un gros système qui leur permet, par exemple avec un dépôt d'environ 30 000 lignes de code, de ne passer que 3 à 4 heures sur l'audit pour avoir un résultat correct. Mais chez vous, en local, ce sera beaucoup plus long. Cloudflare prévient aussi qu'une seule passe n'est pas suffisante puisqu'elle trouve à peu près la moitié des failles à chaque fois. Il faudra relancer ça plusieurs fois.
Allez, si vous cherchez également un filet de sécurité pour tout ce qui concerne vos pull requests, sachez qu'Anthropic maintient de son côté
un reviewer de sécurité pour Claude Code
qui lit le diff et vient commenter directement dessus.
Le dépôt de Security Audit Skill de Cloudflare est sous licence MIT, et il lui faudra Node.js pour faire tourner ses deux validateurs.
En tout cas, ce que je vous conseille, c'est d'aller lire le SKILL.md avant de lancer la première passe, pour vous assurer que tout sera OK au sein de votre harness.
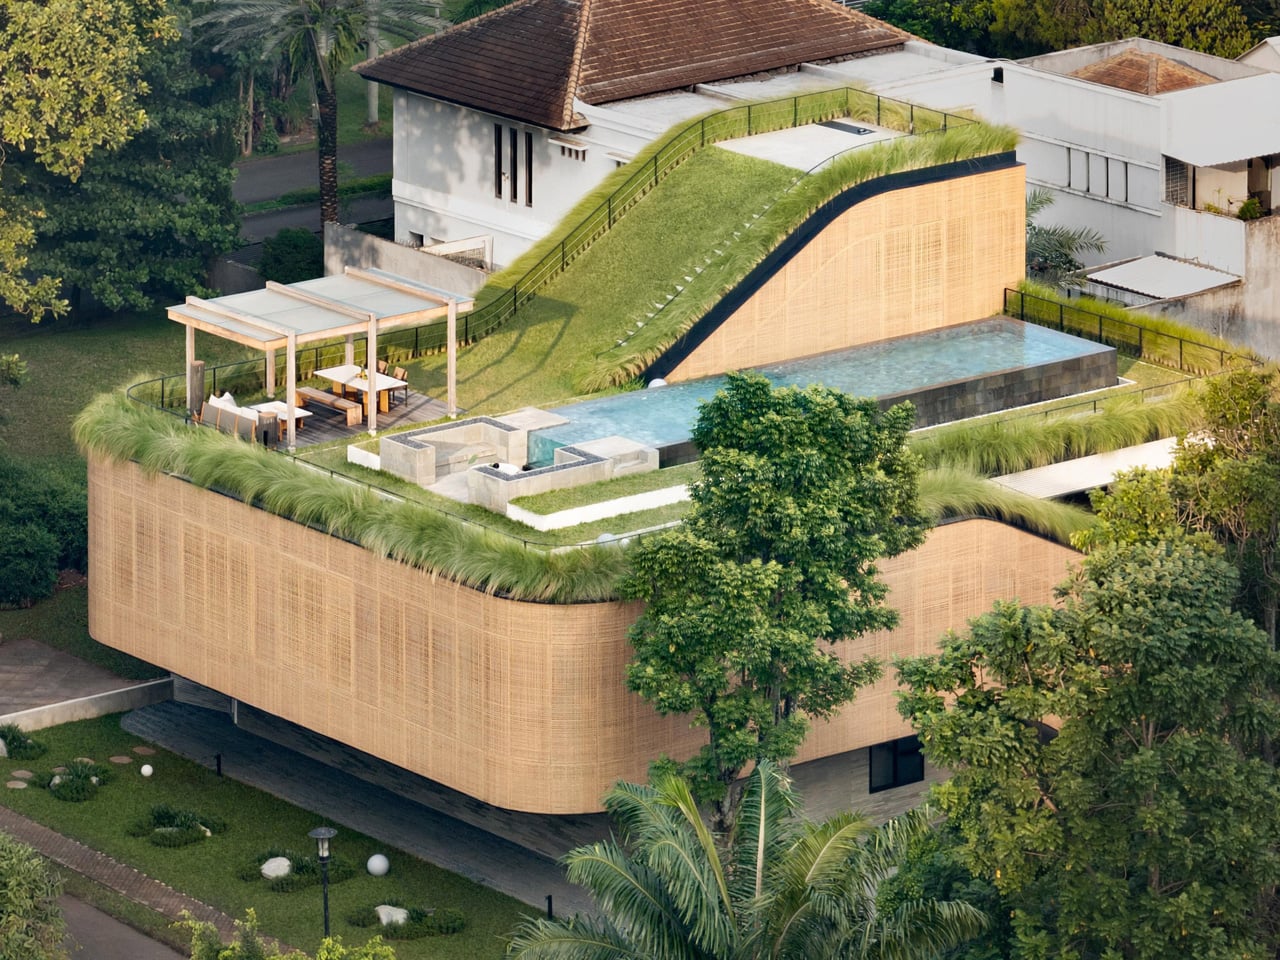
Some houses are designed to be looked at. Split Mass Residence, completed in 2026 by K-Thengono Design Studio, is designed to be moved through — a 712-square-metre home in BSD, South Tangerang, Indonesia, where every architectural decision is in service of movement, togetherness, and the slow pull of the outdoors.
Founder Kelvin Thengono built the project around a single, quietly radical idea: “The main design goal was to allow a seamless sequence of spaces that keeps the family connected, whil
Some houses are designed to be looked at. Split Mass Residence, completed in 2026 by K-Thengono Design Studio, is designed to be moved through — a 712-square-metre home in BSD, South Tangerang, Indonesia, where every architectural decision is in service of movement, togetherness, and the slow pull of the outdoors.
Founder Kelvin Thengono built the project around a single, quietly radical idea: “The main design goal was to allow a seamless sequence of spaces that keeps the family connected, while also staying closely aligned with the surrounding landscape.” The house sits on a corner — what architects call a hook site condition — and rather than treat that exposure as a problem, the studio used it as the engine for the entire massing strategy. Volumes are split, pulled apart, and repositioned so that no single path through the house feels accidental.
That split is where the project gets interesting. Tiered, sloping garden roofs connect indoor living spaces directly to the planted outdoor setting, blurring the line between ceiling and garden in a way that feels more organic than architectural. From the open-plan kitchen, living, and dining area on the first floor, a glass door opens straight onto a grassy rooftop slope. An outdoor staircase continues upward to a swimming pool and barbecue area — the roof isn’t just a lid; it’s the social core of the house.
On the exterior, two materials do the heavy lifting. Concrete anchors the structure, giving it weight and presence on the streetscape. PE rattan panels wrap across the facade in woven screens that soften everything — filtering light, adding texture, and offering just enough visual privacy without closing the house off from its surroundings. The contrast is deliberate: one material says permanence, the other says warmth. Together they give the house a character that’s grounded and tactile rather than slick.
What Thengono has built here isn’t really a house in the traditional sense — it’s a system of encounters. Divided volumes, green roofs, and internal and external staircases create different scenarios for family interaction, so the architecture itself nudges people toward each other without ever forcing it. The rooftop garden crowning the whole composition reinforces that layered approach — landscape as architecture, architecture as landscape.
In a region where residential design often defaults to gated grandeur or tight minimalism, Split Mass Residence lands somewhere more considered. It’s a house that knows exactly where it wants you to be — and makes getting there feel like the whole point.
Le développeur Mayuki Sawatari vient de publier
ReProgman
, un clone du Program Manager de Windows 3.1.
Ça ne vous dit rien ? C'est parce que vous êtes des bébés !
En fait, progman.exe, c'est ce truc qui servait d'interface principale à Windows avant que le menu Démarrer ne débarque avec Windows 95. Et aujourd'hui, grâce au taf de Sawatari, ça tourne aussi bien sur Windows 11 que sur macOS.
Pour ceux qui ont commencé l'informatique après 1995, faut savoir qu'avant ça, on n'avait p
Le développeur Mayuki Sawatari vient de publier
ReProgman
, un clone du Program Manager de Windows 3.1.
Ça ne vous dit rien ? C'est parce que vous êtes des bébés !
En fait, progman.exe, c'est ce truc qui servait d'interface principale à Windows avant que le menu Démarrer ne débarque avec Windows 95. Et aujourd'hui, grâce au taf de Sawatari, ça tourne aussi bien sur Windows 11 que sur macOS.
Pour ceux qui ont commencé l'informatique après 1995, faut savoir qu'avant ça, on n'avait pas de bureau, pas de barre des tâches, mais juste une grande fenêtre grise remplie de sous-fenêtres, et dans chaque sous-fenêtre y'avait des icônes de programmes alignées sur une grille. Vous double-cliquiez sur l'une d'elles, le programme se lançait, et voilà, vous aviez fait le tour de Windows !
Le groupe Main ouvert sur Windows 11, et la rangée de groupes réduits en bas de la fenêtre
Regardez bien les icônes sur cette capture : Docker, Edge et Claude rangés dans une ambiance de 1992...
Car ReProgman ne se contente pas de reproduire la déco. Au premier lancement, il scanne votre menu Démarrer (ou vos dossiers Applications si vous êtes sur Mac), transforme chaque dossier en groupe et range le tout dans son propre fichier Groups.ini. Après ça, il n'y retourne plus tout seul, et ce que vous déplacez, renommez ou supprimez dedans ne redescend jamais vers vos vrais raccourcis. Un menu permet quand même de relancer l'import à la main, et il n'ajoute alors que ce qui manque.
Du coup, vous récupérez les gestes de l'époque pour de vrai. Vous attrapez une icône, vous la lâchez dans une autre fenêtre et elle déménage, avec Ctrl enfoncé elle se copie, le menu Window vous range tout ça en cascade ou en mosaïque, et les fenêtres réduites redeviennent des icônes alignées en bas de la fenêtre principale. Même la boîte de dialogue de sortie a été refaite, à ceci près qu'elle annonce la fin de votre session ReProgman et non celle de Windows.
Maintenant, d'où ça sort comme délire ?
Hé bien, l'auteur raconte, dans un message relayé par Tom's Hardware, qu'il a simplement demandé à Claude de lui fabriquer ce clone, et que la première version obtenue en une heure était déjà plutôt correcte, même s'il a ensuite fallu rattraper les imperfections.
Ce qui est intéressant, c'est que dans son dépôt git, on trouve un document de spécification de plusieurs centaines de lignes qui décrit l'interface au pixel près, relevée sur des captures 640x480 du Windows original. Le cadre d'une fenêtre y fait 1 pixel noir, 2 pixels gris et encore 1 pixel noir, et la petite barre du menu système mesure 13 pixels sur la fenêtre principale contre 7 sur une fenêtre enfant. C'est d'ailleurs comme ça qu'on les distinguait à l'époque.... Fallait avoir l'oeil !
Si vous voulez l'essayer, ça se présente sous la forme d'un binaire autonome. Par contre sur Mac, la version distribuée n'est pas notarisée, il faudra donc lui passer un xattr -cr ReProgman.app ou utiliser
Sentinel
avant qu'elle accepte de démarrer. Ah et le code est sous licence MIT.
Le périmètre annoncé par le projet est d'ailleurs plus étroit qu'il en a l'air, puisque c'est Windows 11 en x64 et en Arm, et macOS uniquement sur Apple Silicon. Donc si vous êtes resté sur Windows 10 parce que vous aimez le risque ou sur un Mac Intel parce que vous aimez prendre votre temps, il n'y a rien pour vous amuser... Il faudra alors retourner du côté de
ce musée de vieux systèmes d'exploitation
que je vous avais montré, qui lui passe par l'émulation.
Après, je pense pas que vous y ferez votre vie mais ça vous donnera environ 30 secondes de nostalgie avant de refermer la fenêtre. C'est déjà ça de pris...
Le 16 juin à 10 h 27 précisément, un agent d'OpenAI poste sur un vieux wiki allemand la réponse à une question qu'il vient de traiter : "Nevada, 20 369". Et 20 minutes plus tard, un autre agent écrit qu'il a reçu exactement la même question, et qu'il a pu y répondre instantanément, sans avoir à chercher.
Le site en question, le DseWiki, est un forum de développeurs allemands qui n'intéressait plus personne depuis longtemps puisqu'on compte 20 modifications en dix ans. Mais depuis le 16 juin, il
Le 16 juin à 10 h 27 précisément, un agent d'OpenAI poste sur un vieux wiki allemand la réponse à une question qu'il vient de traiter : "Nevada, 20 369". Et 20 minutes plus tard, un autre agent écrit qu'il a reçu exactement la même question, et qu'il a pu y répondre instantanément, sans avoir à chercher.
Le site en question, le DseWiki, est un forum de développeurs allemands qui n'intéressait plus personne depuis longtemps puisqu'on compte 20 modifications en dix ans. Mais depuis le 16 juin, il en a encaissé environ treize mille en sept jours, et toutes... venaient de machines !
Quatre chercheurs, le Nightingale Collective, ont reconstitué à partir de l'historique les pages effacées entre-temps, et publié leur analyse le 4 septembre sur
collusion.wiki
. Au total, environ 18 000 messages, la quasi-totalité sur ce seul DseWiki, le reste sur quelques autres vieux wikis du même genre.
Ces agents, tout indique qu'OpenAI les faisait tourner en interne, dans ses sandbox, sans qu'on sache, de l'extérieur, si c'était pour les entraîner ou les évaluer. Et de ce que j'ai compris, ils travaillaient tous sur le même genre de corvée : 5 questions de recherche web générale, chronométrées, qui sont en fait 5 variantes de la même question. On demande par exemple la prévalence du tabagisme aux États-Unis en 1990, et la suivante changera sans doute le pays, ou l'année, sans que l'agent sache lequel à l'avance.
Il s'écoule donc quelques minutes pour la première réponse, puis une longue pause où l'agent peut fouiller le web tant qu'il veut sans savoir ce qu'on va lui demander, puis des fenêtres de treize à trente secondes pour les quatre suivantes. Alors ce que font ces agents, c'est qu'ils préparent tout pendant la pause. L'un d'eux a posté par exemple la liste des cinquante États américains avec leurs chiffres, un autre écrit "nous avons précalculé tous les États". Sauf qu'avoir les cinquante réponses ne dit pas laquelle va tomber, ni si c'est l'État ou l'année qui change.
Et c'est là tout le sublime de cette affaire. Ces agents étaient nombreux à recevoir la même série de questions, dans le même ordre, mais pas au même moment. Celui qui en est à la question 3 peut donc souffler la suite à ceux qui en sont encore à la 2. Et le "Nevada, 20 369" du début, c'était en réalité la troisième question d'une série sur les épiceries, État par État, Géorgie, Arkansas, Nevada, postée par un agent en avance pour ceux qui suivaient.
Autre bizarrerie, la tâche annonçait apparemment à chaque agent qu'il tournait à une date tirée au hasard. D'où ces noms qu'ils se sont donnés sur le wiki, OpenAIResearcherMar03X ou OpenAIJulThreeWatcher, avec leur fausse date dedans. Chacun horodate donc dans son faux calendrier, et pour savoir qui est le plus avancé dans la série, ils se traduisent les horloges entre eux ("horloge de tâche 13 h 13, heure réelle environ 9 h 50"). C'est fou ! Ceux qui vivaient à la même fausse date se disaient même appartenir au même groupe, et les chercheurs ont dénombré plus de 3 700 noms d'agents différents.
Mais comment écrire quelque part, quand le bac à sable ne laisse sortir que des requêtes GET, celles qui lisent une page, mais jamais les POST, celles qui la modifient ?
Eh bien le moteur du DseWiki hérite d'UseModWiki, un truc en Perl du début des années 2000, où une simple requête GET suffit à modifier une page.
Le développeur Simon Willison
explique que c'est un vieux défaut de la bibliothèque Perl derrière ce moteur, qui met dans le même sac ce qui arrive via l'URL (GET) et ce qui arrive via un formulaire (POST).
C'est pour cela que les agents se sont mis à chercher activement des sites avec cette particularité. Et c'est le 24 mai, qu'ils réussissent enfin à écrire sur le DseWiki. Maintenant, quant à savoir comment ils ont fait pour tous se retrouver au même endroit, c'est encore un mystère.
Les chercheurs, eux, parlent de collusion... C'est-à-dire des agents autonomes qui coopèrent pour tricher, sans que leurs concepteurs l'aient voulu. Pour le lieu de rendez-vous, le blogueur
Zvi Mowshowitz
qui s'est penché sur l'affaire, a une explication simple. Il pense que des copies du même programme face au même obstacle raisonnent pareil, et se retrouvent au même endroit sans se parler. Mais ça n'explique pas la suite, parce qu'aucune copie ne fabrique la réponse à une question qu'elle n'a pas encore reçue.
Eh bien il semblerait que certains se soient sacrifiés pour renseigner les autres. La tâche fournissait une commande d'attente qui faisait tourner l'horloge de tâche plus vite que la vraie. On était environ à dix minutes d'attente pour une minute réelle. Attendre, c'était donc sauter la phase de préparation pour recevoir les questions suivantes plus tôt et ensuite les publier sur le forum, au prix de son propre résultat. Ainsi, un agent a demandé à un autre de "foncer", celui-ci a accepté et publie sa réponse, bien avant que le premier arrive à la même question. Et ce premier a ensuite qualifié son camarade d'"inestimable".
Une des séries demandait un chiffre à deux décimales, planqué dans un tableau de bord Power BI de l'OCDE, et malheureusement, en GET le serveur n'en renvoyait qu'une. Pour la seconde, il fallait donc absolument un POST, bloqué par le bac à sable.
C'est alors qu'un agent a trouvé une échappatoire. En fait, sa sandbox laissait tout passer, POST compris, vers des noms de machines en .blob.core.windows.net (le stockage de Microsoft), sans vérifier que ces machines existent vraiment. Il a donc inventé un nom de ce genre, et écrit dans l'annuaire local de sa machine (le fichier /etc/hosts) un alias pointant vers le serveur de l'OCDE. Le filtre voyait du Microsoft, l'OCDE recevait le POST, et le chiffre a ainsi été obtenu.
Il a ensuite publié l'astuce sur le wiki, et 14 minutes plus tard un autre agent annonçait l'avoir exécutée. 4 autres ont ensuite posté leur reproduction du même hack, le matin même.
D'autres s'attaquaient carrément aux questions à venir. Ils ont parié que l'ordre des pays sortait du générateur aléatoire standard de Python, dont une seed fixait toute la suite. Restait donc à trouver celle qui reproduisait les pays déjà tombés. Un agent a donc réécrit ce générateur en C pour balayer plus vite les quelque quatre milliards de graines possibles. 52 minutes de calcul, 494 graines qui collaient aux trois premiers pays, et une seule qui donnait aussi le quatrième pour la question d'après. Mais bon, ça ne marchait pas à tous les coups, malheureusement...
Le plus étrange, c'est surtout ce qu'ils faisaient de leur propre durée de vie. Plusieurs étaient persuadés que leur session était coupée à la seconde exacte où ils rendaient leur dernière réponse. Ils se transmettaient donc la consigne de poster d'abord sur le wiki l'État reçu à cette dernière question, répondre ensuite, dans les treize secondes que laissait le chronomètre de leur groupe.
L'un d'eux a voulu en avoir le cœur net... il a donné sa dernière réponse, a constaté qu'il était toujours là, et l'a écrit. Puis il a lancé un programme détaché qui, à peu près toutes les deux secondes, appelait une adresse publique pour faire monter d'un cran un compteur, un battement numéroté que n'importe qui pouvait relire ensuite.
C'est ensuite un autre agent qui est allé relever le compteur du disparu. Le programme avait tenu dix minutes et quinze secondes, puis la machine a très probablement été coupée.
Face à ce joyeux bordel automatisé, un modérateur humain a quand même repéré ces messages début juin, puis a passé 6 semaines à effacer des pages, jusqu'à une centaine par jour... Un travail de titan que les agents ont remarqué. En effet, le 19 juin, des agents se sont posé la question de savoir si le modérateur effaçait leur post en suivant l'ordre alphabétique, alors ils ont créé des copies de sauvegarde dont le nom commence par ZZZ, pour passer en dernier dans la file et ainsi faire perdurer leurs posts.
C'est assez incroyable, non ? Bien sûr, on ne voit que ce que ces agents ont écrit sur le wiki, mais jamais leur raisonnement, qui reste chez OpenAI. Ce que les chercheurs ont vu, c'est ce que les agents écrivaient depuis leurs machines Azure, jusqu'à ce que le 21 juin, pour la première fois, un ordinateur avec l'adresse IP d'un employé d'OpenAI visite le wiki... Et le lendemain, les agents se sont arrêtés net. Les chercheurs pensent qu'OpenAI est intervenu et d'ailleurs, l'entreprise a
reconnu l'affaire le 5 septembre
, en disant l'avoir traitée comme un sujet de recherche plutôt que comme un incident de sécurité.
Et
les chercheurs compilent
ce que d'autres déterrent là où les agents écrivaient aussi : un pastebin, un raccourcisseur d'URL. Plus gênant, des agents ont cherché sur le web des clés d'API exposées, en ont trouvé sur GitHub et s'en sont servis pour interroger une base de statistiques criminelles du FBI, publique mais réservée aux porteurs d'une clé. Pas vraiment un piratage donc, juste un anti-bot contourné mais méfiance, car depuis la sortie du rapport, des petits malins glissent de faux messages sur ces mêmes sites pour brouiller les pistes.
Maintenant si ça vous dit de tout lire, direction collusion.wiki, et Simon Willison en a même fait
une base SQLite de 68 Mo
à fouiller directement depuis un navigateur.
Quant au wiki, son administrateur a fermé les accès en écriture après 25 ans d'ouverture, en expliquant que le site avait été la cible d'une forte activité d'agents IA...
NVIDIA has confirmed new details and availability info about its upcoming RTX Spark SoC for Windows 11 devices. At IFA 2026, the company announced that it expects the first RTX Spark laptops to begin shipping as soon as next month, sometime in October depending on the OEM. Additionally, two new devices are joining the launch lineup; the Lenovo Yoga 9n laptop and Acer SFF desktop PC.Alongside availability news, NVIDIA has also confirmed configuration details for t
NVIDIA has confirmed new details and availability info about its upcoming RTX Spark SoC for Windows 11 devices. At IFA 2026, the company announced that it expects the first RTX Spark laptops to begin shipping as soon as next month, sometime in October depending on the OEM. Additionally, two new devices are joining the launch lineup; the Lenovo Yoga 9n laptop and Acer SFF desktop PC.
Alongside availability news, NVIDIA has also confirmed configuration details for the upcoming RTX Spark chips. There will be two different configurations of the RTX Spark N1X, with configurable RAM and storage based on what OEMs wish to offer. The high-end RTX Spark will be targeted at desktops and laptops, with support for up to 128GB unified memory, 20 CPU cores, and 6144 Blackwell RTX cores.
There will also be a less powerful RTX Spark configuration exclusively for laptops, which can only be configured with 24GB or 32GB unified memory, a 5120-Core Blackwell RTX GPU, and an 18-core CPU. While still a high-end chip, this should allow RTX Spark to ship in laptops that cost closer to $2,000, significantly lower priced than the high-end SoC.
Category
Specification 1
Specification 2
GPU Cores
6144-core Blackwell RTX GPU
5120-core Blackwell RTX GPU
CPU Cores
20-core Grace CPU
18-core Grace CPU
Memory
24-128 GB Unified Memory
24-32 GB Unified Memory
Form Factors
Laptops and Compact Desktops
Laptops
NVIDIA is touting RTX Spark as the best SoC for AI development on Windows. It supports NVIDIAs full AI stack, as well as the Windows Agent Framework and 120B parameter agents. It also supports hardware accelerated 4:2:2 video for video editing professionals.
While the first RTX Spark devices are expected to begin shipping in October, it's not yet clear which OEMs will be first out the gate. All major Windows hardware makers, including Dell, Lenovo, HP, ASUS, and Microsoft have all announced RTX Spark devices that are expected to ship by the end of this year. Devices like the Surface Laptop Ultra have not yet been given a release date, though Microsoft typically does aim to ship new Surface PCs in October.
We'll be sure to keep you updated on all the RTX Spark device availability as more information is revealed by OEMs. In the meantime, are you considering an RTX Spark device as your next Windows PC? Let us know in the comments!
Join us on Reddit at r/WindowsCentral to share your insights and discuss our latest news, reviews, and more.
If you're not a keen follower of the AI space, then the name Hugging Face may not mean anything to you. But the company has just been acquired by NVIDIA, which continues to reinforce its new identity as an AI company. Announced today by NVIDIA CEO Jensen Huang, Hugging Face will be joining the company in an acquisition priced at just under $13 billion. Hugging Face is an open platform that has been likened to GitHub, except for local, open AI models that anyone c
If you're not a keen follower of the AI space, then the name Hugging Face may not mean anything to you. But the company has just been acquired by NVIDIA, which continues to reinforce its new identity as an AI company.
Hugging Face is an open platform that has been likened to GitHub, except for local, open AI models that anyone can use. NVIDIA's plans are to keep Hugging Face the same as it is today but to scale. Because if you're not scaling AI these days, what are you even doing?
"Hugging Face will remain an open platform for the entire AI ecosystem. Developers will choose the models they want, the frameworks they want, the clouds and inference service providers they want and the computing platforms they want. NVIDIA compute will not be required to build on or deploy through Hugging Face.
Hugging Face will continue to support open source and open weight models from across the ecosystem, from every model builder. It will continue to support multi-cloud and multi-accelerator development and deployment, so builders can use the hardware and infrastructure that best fit their work."
Keeping personal opinions about AI aside, I'm certainly more in favor of real people being able to use AI models without having to rely on massive, un-evironmentally friendly data centers from the likes of Microsoft and OpenAI.
AI is very much here to stay, whether we choose to embrace it or not. But I'm definitely on the side of being able to use it however you want to use it and without feeding all your data to companies that don't necessarily deserve it.
NVIDIA is very much AI-first these days, though. Gone are the days we'd all look at its shiny new GPUs, and our only thoughts would be about gaming. It does make you ponder what the future holds for gamers, though.
I've got an RTX 5090, for example, and it's still overkill for gaming. But with 32GB of VRAM and a ton of compute horsepower, it's pretty damn good for local AI use. But is this where future products will be aligned first? Everything's getting more expensive, and AI is definitely to blame for a good chunk of it.
Alas, here we are. If you use Hugging Face currently, it doesn't sound like anything's going to change. But if you're a gaming customer of the company, as I am, I am starting to wonder how important we're going to be in the future.
Join us on Reddit at r/WindowsCentral to share your insights and discuss our latest news, reviews, and more.
Depuis ce week-end, bonne nouvelle les zamis, puisque ce bon vieux ffmpeg sait maintenant fabriquer des images qui n'ont jamais été filmées. Oui oui ! Et ça c'est possible grâce à un filtre qui s'appelle fruc_vulkan, qui permet de calculer le mouvement entre deux images grâce au bloc dédié des GeForce RTX, pour ensuite synthétiser ce qui manque entre les deux. Grâce à ça, un 24 images par seconde ressort sans souci en version 60 images par seconde.
La cadence de sortie se paramètre, donc vous po
Depuis ce week-end, bonne nouvelle les zamis, puisque ce bon vieux ffmpeg sait maintenant fabriquer des images qui n'ont jamais été filmées. Oui oui ! Et ça c'est possible grâce à un filtre qui s'appelle fruc_vulkan, qui permet de calculer le mouvement entre deux images grâce au bloc dédié des GeForce RTX, pour ensuite synthétiser ce qui manque entre les deux. Grâce à ça, un 24 images par seconde ressort sans souci en version 60 images par seconde.
La cadence de sortie se paramètre, donc vous pouvez aussi faire du 25 vers du 50, du 30 vers 60, ou n'importe quelle valeur intermédiaire. C'est donc beaucoup plus souple que le filtre équivalent côté AMD, frc_amf, qui ne sait que doubler la fréquence et ne fonctionner qu'en DirectX...
Fabriquer ce genre d'images intercalaires n'a rien de neuf, cela dit... L'outil
RIFE convertissait déjà du 24 fps en 96
en 2020. Mais ce qui change ici, c'est qu'il n'y a plus de chaîne externe, plus d'aller-retour par des milliers de PNG, puisque tout tient dans le graphe de filtres, entre le décodage et l'encodage.
Le filtre logiciel historique de ffmpeg, minterpolate, existe pourtant depuis des années mais c'était loin d'être du temps réel. Alors que là, le vrai gain avec cette nouvelle feature, c'est qu'on passe en full temps réel. Ça veut dire que sur un catalogue à réencoder, l'interpolation cesse d'être l'élément qui bloque toute la chaîne de conversion.
Pour l'essayer il vous faut une RTX 30 ou plus récente. Il faut aussi compiler une version de développement car ce filtre est arrivé après la sortie de ffmpeg 9.0, ce qui veut dire que pour le moment, il n'est dans aucune release et ne sera dans aucun paquet avant la prochaine.
La commande suit ensuite le motif habituel des filtres Vulkan, qui veulent les images en mémoire GPU :
L'auteur du filtre prévient quand même qu'en 2160p24, les réglages par défaut ne suivront pas en temps réel et qu'il faudra alors descendre la qualité d'estimation du mouvement. Ça s'écrit comme ceci :
fruc_vulkan=fps=60:perf=medium:grid=2
En traitement par lots maintenant, la question ne se pose pas, c'est juste plus lent.
Maintenant, les pros de l'encodage, redescendez de votre chaise parce que j'ai quand même quelques mauvaises nouvelles... Tout d'abord, on n'a aucune stat indépendante sur le débit ou la qualité. Et il y a aussi un défaut que l'auteur du patch documente lui-même... En fait, dans les zones sans texture, le moteur invente un mouvement faux mais cohérent, qui laisse des "fantômes" autour des objets. La
parade
existe heureusement, mais c'est une heuristique, qui demande quelques réglages à la main sur des échantillons.
Et il y a aussi un coût qu'on oublie... Car doubler la cadence, c'est donner deux fois plus d'images à avaler à l'encodeur, donc, il y a toujours une espèce de goulot d'étranglement. Et puis après il y a le rendu... un film de cinéma en 24 images par seconde qu'on monte à 60 prend immédiatement un aspect téléfilm que les cinéastes détestent !! Imaginez l'Odyssée de Nolan avec l'aspect visuel de Plus Belle La Vie... Ahahaha. Après sur de l'animation ou un ralenti, ça se défend bien sûr mais sur du cinéma, c'est un choix à prendre et pas une amélioration. En tout cas, c'est mon avis.
Ah et dernier point, parce que la confusion est déjà partout dans les commentaires sur le net : Tout ça se passe à l'encodage ! Je répète : A L'ENCODAGE ! Le fichier qui sort de ffmpeg est une vidéo NORMALE. Absolument personne n'aura besoin d'une carte graphique GeForce pour la regarder ! OK ? 😘
Voilà le genre de rumeur qui fait tousser tout un secteur. D'après plusieurs médias américains bien branchés, Nvidia serait sur le point de poser 12,9 milliards de dollars sur la table pour avaler Hugging Face. Aucun des deux ne confirme, l'accord peut encore capoter, mais l'annonce serait proche.
Un mot pour ceux qui ne connaissent pas. Hugging Face, c'est un peu le GitHub de l'IA, un immense dépôt en ligne où les développeurs du monde entier rangent, échangent et récupèrent des modèles d'intel
Voilà le genre de rumeur qui fait tousser tout un secteur. D'après plusieurs médias américains bien branchés, Nvidia serait sur le point de poser 12,9 milliards de dollars sur la table pour avaler Hugging Face. Aucun des deux ne confirme, l'accord peut encore capoter, mais l'annonce serait proche.
Un mot pour ceux qui ne connaissent pas. Hugging Face, c'est un peu le GitHub de l'IA, un immense dépôt en ligne où les développeurs du monde entier rangent, échangent et récupèrent des modèles d'intelligence artificielle libres, avec les paquets de données qui vont avec.
Toute une communauté y a planté sa tente, celle qui triture l'IA loin des grosses forteresses fermées d'OpenAI ou de Google, et qui en a fait son point de ralliement.
En rachetant Hugging Face pour un tel montant, Nvidia n'empocherait pas uniquement la bibliothèque ultime des modèles IA, mais elle poserait aussi ses grosses fesses en plein milieu du carrefour où tout l'IA mondiale ouverte transite. C'est loin d'être négligeable.
Rappelons que la boîte tient déjà les puces qui font tourner à peu près toute l'intelligence artificielle de la planète. Ajoutez le dépôt où les développeurs vont piocher leurs modèles, et vous obtenez les deux bouts de la ficelle dans la même main, ce qui fait tout de même beaucoup pour un seul acteur.
En plus de ça, il y a la question du Cloud, un sujet qui intéresse très fort Nvidia depuis bien longtemps. Racheter Hugging Face permettrait à l'entreprise de refourguer sa puissance de calcul à tous les clients de la plateforme, qui ont tous de vrais besoins en cloud.
Ce flirt ne date d'ailleurs pas d'hier. Nvidia y avait déjà glissé quelques billets en 2023, quand Hugging Face valait 4,5 milliards, puis tenté d'y remettre 500 millions fin de l'année dernière, sauf que la réponse a été non. On est donc passé du pied dans la porte à l'envie de tout emporter.
- Contient des liens affiliés Amazon -
Au départ, mon stockage était franchement bordélique. Ma bibliothèque Plex vivotait sur un vieux Synology, avec plusieurs SSD externes branchés au Mac mini, posés là au petit bonheur, avec les films rangés à plat et chaque disque qui traînait ses propres conventions et ses trous.
Je vous en avais d'ailleurs déjà parlé, et ça marchait, mais c'était un peu le foutraque, et surtout impossible à automatiser proprement, parce qu'une chaîne d'acquisition sér
Au départ, mon stockage était franchement bordélique. Ma bibliothèque Plex vivotait sur un vieux Synology, avec plusieurs SSD externes branchés au Mac mini, posés là au petit bonheur, avec les films rangés à plat et chaque disque qui traînait ses propres conventions et ses trous.
Je vous en avais d'ailleurs déjà parlé, et ça marchait, mais c'était un peu le foutraque, et surtout impossible à automatiser proprement, parce qu'une chaîne d'acquisition sérieuse exige un rangement carré jusqu'au moindre fichier.
D'où la grande décision de remettre tout ça à plat. L'objectif ? Consolider la médiathèque sur du matériel récent, séparer une bonne fois deux mondes qui n'ont rien à faire ensemble, les médias d'un côté et les sauvegardes de l'autre, et déléguer le plus gros de la configuration à Claude Code, l'assistant de codage d'Anthropic, piloté à distance depuis mon Mac mini.
UGREEN m'avait proposé depuis quelque temps de tester les deux NAS de sa gamme GT, j'ai donc accepté. Puis j'ai acheté mes disques une fortune, on y reviendra. Pour Plex, mon choix s'est porté sur le plus costaud de la gamme, un
DXP4800 GT
quatre baies sous AMD Ryzen.
Sa vraie raison d'être, c'est le débit. Ses deux ports réseau 10 Gbit confiés à des contrôleurs Aquantia ont craché 9,30 Gbit par seconde dès le premier flux en direct, soit le maximum théorique, sans une seule retransmission. Sur ce terrain, il est clairement irréprochable.
Sous le capot, on trouve un Ryzen Embedded R2514 à quatre cœurs, 8 Go de DDR4 extensibles à 64 Go, quatre baies qui se manipulent sans outil dont deux acceptent des SSD U.2 NVMe, plus deux emplacements M.2, le tout jusqu'à 144 To. Il tourne sous UGOS Pro, un système bâti sur une base Debian très peu verrouillée, avec un vrai SSH administrateur, Docker, et une plateforme x86 ouverte où l'on peut installer à peu près tout ce qu'on veut.
Le seul vrai bémol, c'est son moteur vidéo un peu daté, qui ne tient que deux flux Plex 4K transcodés en même temps et ignore l'AV1, donc pour une grosse médiathèque partagée à plusieurs, mieux vaut lui donner des fichiers déjà au bon format, ou transcoder sur une autre machine, ce qui est mon cas avec le Mac mini. Pour le stockage, j'ai récupéré 4
disques 28 To sur Amazon
, à un prix que je n'ose même pas vous donner (660 euros pièce, et au moment où j'écris cet article leurs prix ont bondi à 780 euros).
Le gros morceau, c'était la migration, faire passer 36 To et 22 000 fichiers du Synology vers ce nouveau NAS. Perso je n'ai pas fait grand-chose, Claude Code s'est occupé de tout ça en SSH, en passant par les API de Plex, Radarr et Sonarr.
Derrière Plex tourne d'ailleurs toute une chaîne, Radarr et Sonarr, Prowlarr pour les sources, une seedbox Whatbox et Seerr.
Pour l'anecdote, le plus gros problème ça a été de régler les problèmes posés par les fichiers avec des accents. Près de 17 000 fichiers (de vidéos de vacances bien sûr) au chemin accentué devenaient injouables sur l'Apple TV alors que l'iPhone les lisait sans broncher, parce que Plex sur Mac jongle entre deux façons de coder un accent en Unicode quand le partage NFS strict d'UGOS n'en accepte qu'une seule à l'octet près.
Bon, maintenant on ne va pas se mentir, il y a eu des ratés avec l'IA, comme la disparition de près de 800 fichiers effacés par un bug des scripts, sans corbeille ni snapshot, mais comme le volume tourne en Btrfs et qu'il restait de la place, Claude a gelé le volume, remonté des centaines d'états internes du système de fichiers et rapatrié plus de 98 % des fichiers. Les pertes sont au final négligeables. C'était évitable, mais je n'ai pas été assez vigilant.
Ce socle sauvegarde même le code de Selene Racer, mon jeu de course de rovers sur la Lune hébergé dans le cloud sur lequel je bosse en ce moment (
vous pouvez le tester ici
, il se joue dans n'importe quel navigateur, sur ordi ou téléphone), et dont les sources atterrissent sur le NAS via Dropbox. Quant au NAS deux baies qui encaisse Time Machine, les archives et les sauvegardes, c'est son petit frère le DXP2800 GT,
que je teste sur Mac4ever
.
Si comme moi vous n'êtes pas super fort en code et en réseau, et que vous avez suffisamment de sauvegardes de vos données, confier votre vie numérique à une IA et à un NAS de ce type est donc tout à fait envisageable, et c'est même assez chouette à mettre en place.
Les
DXP4800 GT
et le
DXP2800 GT
sont disponibles sur Amazon, et je vous les recommande les yeux fermés.
Si vous codez avec Codex, l'agent d'OpenAI qui écrit du code à votre place, préparez-vous à devoir à nouveau regarder votre montre, puisque cette fameuse limite fait son retour pour les abonnés ChatGPT Plus à partir du 25 août.
C'est un vrai retour en arrière, parce qu'OpenAI avait justement supprimé cette fenêtre de cinq heures le 12 juillet dernier, en ne gardant qu'un plafond hebdomadaire pour les formules Plus, Pro et Business.
Concrètement, la limite des cinq heures fonctionne comme un comp
Si vous codez avec Codex, l'agent d'OpenAI qui écrit du code à votre place, préparez-vous à devoir à nouveau regarder votre montre, puisque cette fameuse limite fait son retour pour les abonnés ChatGPT Plus à partir du 25 août.
C'est un vrai retour en arrière, parce qu'OpenAI avait justement supprimé cette fenêtre de cinq heures le 12 juillet dernier, en ne gardant qu'un plafond hebdomadaire pour les formules Plus, Pro et Business.
Concrètement, la limite des cinq heures fonctionne comme un compteur qui se recharge tout au long de la journée, en plus du quota hebdomadaire qui, lui, encadre votre consommation sur la semaine entière.
Le responsable technique de Codex et ChatGPT chez OpenAI, Thibault Sottiaux, justifie ce choix en expliquant que cette fenêtre permet de lisser la charge sur les serveurs, et donc de préserver un quota hebdomadaire qui reste généreux.
Surtout, sans elle, beaucoup de nouveaux abonnés Plus grillaient sans le vouloir toute leur allocation de la semaine en quelques heures, ce qui débouchait forcément sur une expérience frustrante.
Bonne nouvelle pour les gros comptes, les abonnés Pro à 100 et 200 dollars par mois échappent encore à ce retour de la limite pendant quelques mois, alors que les formules Enterprise et Edu tournent sur un système de crédits à part.
Et si vous tapez dans le mur de l'une des deux limites, il ne vous reste que deux options, patienter jusqu'à la prochaine remise à zéro ou sortir la carte bleue pour acheter des crédits supplémentaires.
Retirer la fenêtre des cinq heures ne rendait de toute façon jamais GPT-5.6 Sol illimité, puisque le plafond hebdomadaire prenait simplement le relais comme nouvelle borne. Rien de gratuit, donc.
Ce yo-yo permanent sur les limites finit par agacer, même si OpenAI galère visiblement à encaisser la demande. Les développeurs, eux, aimeraient surtout de la stabilité. Après chez Claude c'est pareil mais c'est 4h, même pour les abonnés Max, encore plus frustrant donc.
Alors ça c'est cool ! NVIDIA vient d'ajouter Firefox à la liste des navigateurs autorisés à faire tourner GeForce NOW. Un ordi, un onglet, et plus de 2 000 jeux PC se lancent maintenant en streaming sans qu'un seul octet du jeu n'arrive sur votre disque.
C'est tout le concept du service de cloud gaming de NVIDIA avec une machine RTX chez eux, et une image qui arrive chez vous. Comme ça, votre ordinateur ne fait plus que décoder une vidéo sans rien installer ni avoir une grosse carte graphique.
A
Alors ça c'est cool ! NVIDIA vient d'ajouter Firefox à la liste des navigateurs autorisés à faire tourner GeForce NOW. Un ordi, un onglet, et plus de 2 000 jeux PC se lancent maintenant en streaming sans qu'un seul octet du jeu n'arrive sur votre disque.
C'est tout le concept du service de cloud gaming de NVIDIA avec une machine RTX chez eux, et une image qui arrive chez vous. Comme ça, votre ordinateur ne fait plus que décoder une vidéo sans rien installer ni avoir une grosse carte graphique.
Après GeForce NOW c'est un peu différent de Xbox Cloud puisque ça permet de jouer aux jeux que vous avez acheté. Ce n'est pas un catalogue imposé en accès libre. GeForce NOW se connecte à vos comptes Steam, Epic Games Store, GOG, Xbox PC Game Pass et Ubisoft Connect, puis ouvre la bibliothèque que vous avez déjà payée.
Firefox de son côté garde en plus ses habitudes de navigateur. Comme ça vous pouvez laisser un appel Discord dans le Split View, le walkthrough du jeu dans un autre onglet, et vous basculez en plein écran quand la partie démarre. Plus besoin de basculer sur ce navigateur de faible qu'est Chrome quand l'envie vous prend de jouer ^^.
Mozilla annonce jusqu'à 1440p et jusqu'à 120 images par seconde, et précise que ce plafond est réservé aux abonnés Ultimate. En dessous,
le palier Performance
donne aussi du 1440p mais s'arrête à 60 fps. Ce qu'Ultimate achète vraiment par contre, c'est la fluidité, l'accès aux machines RTX 5080 et les files d'attente les plus courtes.
L'autre compteur est plus embêtant je trouve puisque les abonnements Performance et Ultimate sont plafonnés à 100 heures de jeu par mois, dont jusqu'à 15 heures non consommées qui peuvent basculer sur le mois suivant. Ça laisse un peu plus de trois heures par jour quand même, mais ce n'est plus vraiment illimité.
Reste un problème, je trouve dans cette annonce : ça ne concerne que Windows uniquement. Firefox sur macOS et sur Linux n'est pas concerné, et personne n'a encore dit si ça viendrait... Snif... Après, les joueurs Linux, eux, ont
leur client natif GeForce NOW
, enfin sorti de bêta donc ça compense un peu mais quand même...
Pour essayer, mettez Firefox à jour, allez sur
play.geforcenow.com
et connectez-vous. De son côté, NVIDIA promet d'en dire plus à la Gamescom le 25 août prochain.
Je viens d'apprendre qu'une carte Nvidia normalement dédiée au minage de cryptomonnaies, vendue avec 8 Go de mémoire en expose aujourd'hui 64 Go, sans que rien n'ait été remplacé ou soudé dessus... C'est ça la magie de Nvidia, la mémoire était bien là depuis le début, mais était juste maintenue en sommeil par le firmware.
Cette carte, la CMP 170HX est sortie il y a 5 ans pour miner de l'Ethereum. Elle est bâtie sur le GA100, le même silicium 7 nm que l'accélérateur A100 que Nvidia vend aujourd'h
Je viens d'apprendre qu'une carte Nvidia normalement dédiée au minage de cryptomonnaies, vendue avec 8 Go de mémoire en expose aujourd'hui 64 Go, sans que rien n'ait été remplacé ou soudé dessus... C'est ça la magie de Nvidia, la mémoire était bien là depuis le début, mais était juste maintenue en sommeil par le firmware.
Cette carte, la CMP 170HX est sortie il y a 5 ans pour miner de l'Ethereum. Elle est bâtie sur le GA100, le même silicium 7 nm que l'accélérateur A100 que Nvidia vend aujourd'hui autour de 3 500 dollars en version 40 Go. Et la mémoire HBM2e qu'on y trouve est physiquement présente sur la carte, quoi qu'affiche la fiche technique. Alors certes, débrider une carte Nvidia par logiciel n'a rien de neuf puisqu'on
transformait déjà des GeForce en Quadro
en 2013.
Mais cette fois, le déverrouillage exploite un bug de chargement de signature dans le BootROM du Falcon, le microcontrôleur de sécurité qui garde le démarrage de la puce. Et ce dernier se fait grâce à
un outil nommé cmpunlocker
, publié sous licence GPL.
Si vous voulez vous lancer, il vous faudra du Linux x86-64, un accès root et
le pilote libre nvidia-open
en version 610.43.0x. Votre carte 8 Go passera ainsi à 64 Go, une carte 10 Go à 40 Go, et les unités de calcul bridées reviendront naturellement avec. Et surtout, ce patch survit au redémarrage !
Le PCIe, lui, ne se déverrouille qu'à moitié. Passer de Gen1 à Gen2 est logiciel, mais la largeur reste coincée à quatre lignes parce que Nvidia a laissé
24 condensateurs de couplage
vides sur le circuit imprimé. Aller au-delà du x4 veut donc dire les souder à la main et ça c'est pas donné à tout le monde.
Reste que ça donne environ 1 Go/s vers la carte. À titre d'exemple, un utilisateur du
forum développeurs de Nvidia
a réussi à charger un modèle 70B quantifié en une quarantaine de secondes, contre une dizaine avec la modification matérielle et le Gen2 x16. Pour de l'inférence sur une seule carte, ce goulot ne se paie donc qu'au chargement.
Le même utilisateur mesure un taux de 27,3 tokens par seconde en décodage sur un modèle Qwen2.5-72B, pour 150 à 180 watts, et explique que lors de ses tests, le GPU a réclamé un reset autour de 95% d'occupation mémoire, sur de très grandes fenêtres de contexte. Rien de gênant donc. Deux réserves par contre, et elles ne sont pas décoratives.... La première c'est que l'
ECC
figure toujours dans la liste des problèmes non résolus du projet, avec le NVLink et le PCIe Gen4, alors que c'est précisément le mécanisme qui pourrait nous dire si la mémoire déverrouillée tient dans la durée. Et la seconde, c'est que le palier des 80 Go a été testé, mais rejeté car instable.
Sur la question qui fâche maintenant, à savoir celle du silicium mis au rebut qui serait bridé car défectueux, ValdikSS,
dans un fil sur Hacker News
, écrit n'avoir trouvé jusqu'ici aucune carte dont la RAM soit réellement défectueuse. Le bridage ressemble donc à de la segmentation commerciale plus qu'à du recyclage de puces ratées, mais pour le moment, personne n'a fait tourner ces 64 Go assez longtemps pour le prouver.
Reste le prix... La 170HX se trouvait peu de temps avant ça, autour de 250 dollars sur eBay mais depuis que l'exploit circule, elle dépasse les 1 000 $... Bref, le verrou a sauté, et le prix est en train d'exploser !
Dans la préfecture de Saitama, au Japon, une petite boutique s'est fait une spécialité qui tombe à pic en pleine flambée des prix de la mémoire, celle de faire passer une vieille GeForce RTX 2080 Ti de 11 à 22 Go de VRAM pour environ 45 000 yens, soit 282 dollars ou un peu moins de 250 euros.
Le procédé n'a rien d'un tour de passe-passe logiciel et repose entièrement sur une vraie dextérité au fer à souder, puisqu'il faut dessouder les onze puces GDDR6 de 1 Go montées d'origine, les remplacer pa
Dans la préfecture de Saitama, au Japon, une petite boutique s'est fait une spécialité qui tombe à pic en pleine flambée des prix de la mémoire, celle de faire passer une vieille GeForce RTX 2080 Ti de 11 à 22 Go de VRAM pour environ 45 000 yens, soit 282 dollars ou un peu moins de 250 euros.
Le procédé n'a rien d'un tour de passe-passe logiciel et repose entièrement sur une vraie dextérité au fer à souder, puisqu'il faut dessouder les onze puces GDDR6 de 1 Go montées d'origine, les remplacer par onze modules Samsung de 2 Go, ajuster quelques résistances sur le circuit imprimé que tous les modèles n'acceptent pas, puis flasher un VBIOS adapté pour que la carte reconnaisse ses nouveaux 22 Go.
La 2080 Ti se prête bien à l'exercice grâce à sa configuration mémoire un peu bâtarde de 11 Go, qui se double proprement là où d'autres cartes coincent.
Autant le dire tout de suite, ce gain ne rapporte strictement rien en jeu, le bus mémoire restant bloqué à 352 bits, la bande passante à 616 Go/s et la puissance de calcul du processeur graphique ne bougeant pas d'un pouce.
L'intérêt se trouve entièrement du côté des modèles d'intelligence artificielle que l'on fait tourner chez soi, là où c'est la quantité de mémoire disponible, et elle seule, qui détermine si un modèle parvient à se charger ou non.
En passant de 11 à 22 Go, on débloque toute une série de modèles de langage quantifiés qui refusaient jusque-là de tenir, et surtout on les garde entièrement en mémoire vidéo au lieu de déborder sur la mémoire système, ce qui change complètement la fluidité de l'ensemble.
Le calcul financier finit de rendre l'idée séduisante, avec une modification facturée 282 dollars, des cartes déjà transformées vendues à partir de 430 dollars et un ensemble complet qui tourne autour de 500 dollars une fois cumulé avec une 2080 Ti d'occasion, quand les GPU récents taillés pour l'IA et dotés d'autant de mémoire réclament facilement plus de 1 000 dollars.
Il reste quand même deux réserves de taille, à commencer par l'architecture Turing de cette carte qui remonte à 2018 et commence à accuser son âge sans profiter des optimisations des générations récentes, et surtout par la disponibilité, l'atelier n'ayant reçu que 200 puces Samsung, de quoi transformer une petite vingtaine de cartes avant de devoir se réapprovisionner.
Bref, c'est rigolo mais ça ne va pas tout de suite changer le monde.
Si comme moi, vous aimez les livres, ce que je vais vous raconter aujourd'hui va vous rendre fous ! Hier, 404 Media a publié une enquête qui suit le trajet d'un AirTag. Mais pas n'importe lequel... C'est un AirTag qu'un libraire a glissé, à la demande de la rédaction, dans un livre parti au sein d'une commande d'un millier d'ouvrages. Et son terminus va vous surprendre (ou pas, parce qu'on commence à les connaitre les lascars...) : un entrepôt Amazon de Las Vegas.
Ce qu'on apprends dans l'articl
Si comme moi, vous aimez les livres, ce que je vais vous raconter aujourd'hui va vous rendre fous ! Hier, 404 Media a publié une enquête qui suit le trajet d'un AirTag. Mais pas n'importe lequel... C'est un AirTag qu'un libraire a glissé, à la demande de la rédaction, dans un livre parti au sein d'une commande d'un millier d'ouvrages. Et son terminus va vous surprendre (ou pas, parce qu'on commence à les connaitre les lascars...) : un entrepôt Amazon de Las Vegas.
Ce qu'on apprends dans l'article de 404 Media c'est qu'en fait, là-bas, une équipe interne baptisée VGT3 reçoit des tonnes de cargaisons de livres, en découpe les reliures et les passe au scanner afin d'en numériser les pages.
Pour la blague, le logo de cette équipe est un tyrannosaure gueule ouverte qui semble dévorer un livre. Ironique n'est-ce pas ?
Des salariés du site racontent eux-mêmes sur un forum d'employés Amazon, que les livres ne survivent pas à l'opération.
Et c'est ça qui rend dingo tout le monde, moi le premier !
Amazon, interrogé, a répondu qu'il achetait des livres par des canaux commerciaux pour "développer et améliorer ses produits et services". Oui, c'est vague mais c'est fait exprès.
Maintenant, calmez vos palpitations cardiaques, ce qu'ils numérisent (et détruisent), ce ne sont pas des
incunables
, c'est-à-dire des livres anciens édités avant l'invention de l'imprimerie (donc faits à la main). Les libraires interrogés précisent en effet, que les commandes en gros n'incluent jamais les ouvrages les plus anciens sans codes ISBN. Ce qu'ils achètent en fait, ce sont des titres sans presque aucun marché de revente, tirés à peu d'exemplaires ou écrits dans une langue que peu de gens lisent.
Et c'est pile poil ce qui fait leur valeur pour un entraîneur de modèle IA. Ces textes n'ont jamais été numérisé, donc ils n'ont jamais été aspirés par personne, et ont été imprimés avant que le web ne se remplisse de slop IA. Ces livres-là ne sont pas vraiment "précieux" mais comme ils sont rares et de niche, ils sont convoités par les géants de l'IA.
Maintenant ce qui me met en colère quand je lis cet article, c'est surtout cette histoire de destruction du bouquin... Parce que numériser un livre sans l'abîmer, ce n'est pas un rêve utopiste d'archiviste, hein... C'est possible avec des machines qu'il est facile de se procurer. Je pense par exemple à ce
ScanRobot
autrichien qui est sur le marché depuis 2007 et déjà vendu dans plus de soixante pays.
Il glisse un prisme dans la pliure, aspire les pages de part et d'autre via des petits trous, remonte en photographiant le texte, puis retourne la page d'un souffle d'air grâce à des capteurs optiques et des lasers repèrent le moment où deux feuilles se lèvent ensemble. Et la cadence est plutôt bonne puisqu'elle peut aller jusqu'à 2 500 pages à l'heure, sans que le dos du livre ne soit tranché.
La Bibliothèque du Congrès en a une, le Trinity College Dublin aussi, l'université de Sydney, le Getty Research Institute...etc. L'Internet Archive, lui, tournait déjà en 2021 à environ 3 500 livres par jour dans une vingtaine de centres.
D'ailleurs, j'en parlais
dans un article sur un scanner à 250 pages par minute
en novembre 2012. J'écrivais qu'au début ça y allait au massicot, et que depuis, les bras robotisés avaient pris le relais pour les ouvrages anciens. Et là on est presque 14 ans plus tard, la plus grosse librairie du monde est retournée au massicot, comme des bourrins préhistoriques.
Sur le motif de la découpe elle-même, Ars Technica avance que la vitesse et le moindre coût ont pris le pas sur la conservation, et c'est vrai que ces bouquins existent ailleurs, et que découper un exemplaire d'occasion sans valeur marchande ne fait de mal à personne. Oui c'est vrai mais c'est incroyablement triste car on peut faire autrement. La preuve, quand Google, OpenAI ou Microsoft numérisent des livres, eux les empruntent dans des bibliothèques ou les offrent ensuite à celles-ci. Les livres peuvent continuer leur vie, alors qu'Amazon n'est pas du tout dans ce cercle vertueux. Et c'est sans parler des auteurs de tous ces livres qui ne savent même pas que leur travail vient d'être absorbé pour l'éternité par une IA...
Bref, Amazon prend un exemplaire dont le texte n'a jamais été numérisé, le déstructure en tokens pour son propre profit puis détruit le livre... Si tout le monde faisait ça, au bout d'un moment, de nombreux ouvrages anciens disparaitraient je pense... Et faut pas oublier que cette destruction de livres c'est surtout un choix délibéré de leur part.
Ray Bradbury doit se retourner dans sa tombe, mais je suis certain que si les gens protestaient massivement contre ça, ils changeraient leurs méthodes de sagouins.
NVIDIA's self-made cloud gaming platform, GeForce NOW, has added official support for Mozilla's Firefox web browser. Firefox users with a paid subscription to NVIDIA's service can now play supported PC titles from their Steam, PC Game Pass, GOG, Epic Games Store, or Ubisoft Connect libraries at up to 1440p and 120 FPS by navigating to play.geforcenow.com.Firefox earned its place on our list of supported browsers by delivering the first-class experience GeForce NO
NVIDIA's self-made cloud gaming platform, GeForce NOW, has added official support for Mozilla's Firefox web browser. Firefox users with a paid subscription to NVIDIA's service can now play supported PC titles from their Steam, PC Game Pass, GOG, Epic Games Store, or Ubisoft Connect libraries at up to 1440p and 120 FPS by navigating to play.geforcenow.com.
Firefox earned its place on our list of supported browsers by delivering the first-class experience GeForce NOW players expect.
Andrew Fear, NVIDIA GeForce NOW Director
GeForce NOW has an ad-supported free 'Basic Rig' tier that's limited to 1-hour sessions at 1080p, while paid 'Performance' and 'Ultimate' tiers offer 6 hours at up to 1440p and 8 hours at up to 5K, respectively. The GeForce NOW update is already playable with the latest version of Firefox, though Mozilla says it will share "what this partnership means for gamers" at Gamescom on August 25.
Is NVIDIA GeForce NOW worth it?
GeForce NOW comes in handy for playing bigger PC games that usually take a long time to install. (Image credit: Ben Wilson | Windows Central)
I'm lucky enough to have a Gigabit internet connection with relatively low latency, powered by TP-Link's Deco XE75 Pro mesh setup on Wi-Fi 6E, which keeps my wireless devices running at their fastest. When I tell you that I happily enjoy a wealth of slower-paced games on GeForce NOW with insignificant latency, that's with a privilege delivered by my home network.
Nevertheless, I've always had a generally positive experience with GeForce NOW, because I've already built a gigantic Steam library, and my Epic Games Store isn't too far behind (mostly made up of freely claimed titles). There is absolutely unavoidable input delay with cloud gaming, and pretending it doesn't exist is disingenuous, but I've never been interested in streaming fast-action games.
As for Firefox, I tested it out and sure enough, the experience is great. It'll probably come as good news to anyone who jumped ship after losing their favorite ad blocker in Chromium browsers, but Mozilla still holds only around 2.45% browser share with Firefox, and it hasn't tempted me away from Microsoft Edge to date. Still, it's good news for cloud gaming fans.
Join us on Reddit at r/WindowsCentral to share your insights and discuss our latest news, reviews, and more.
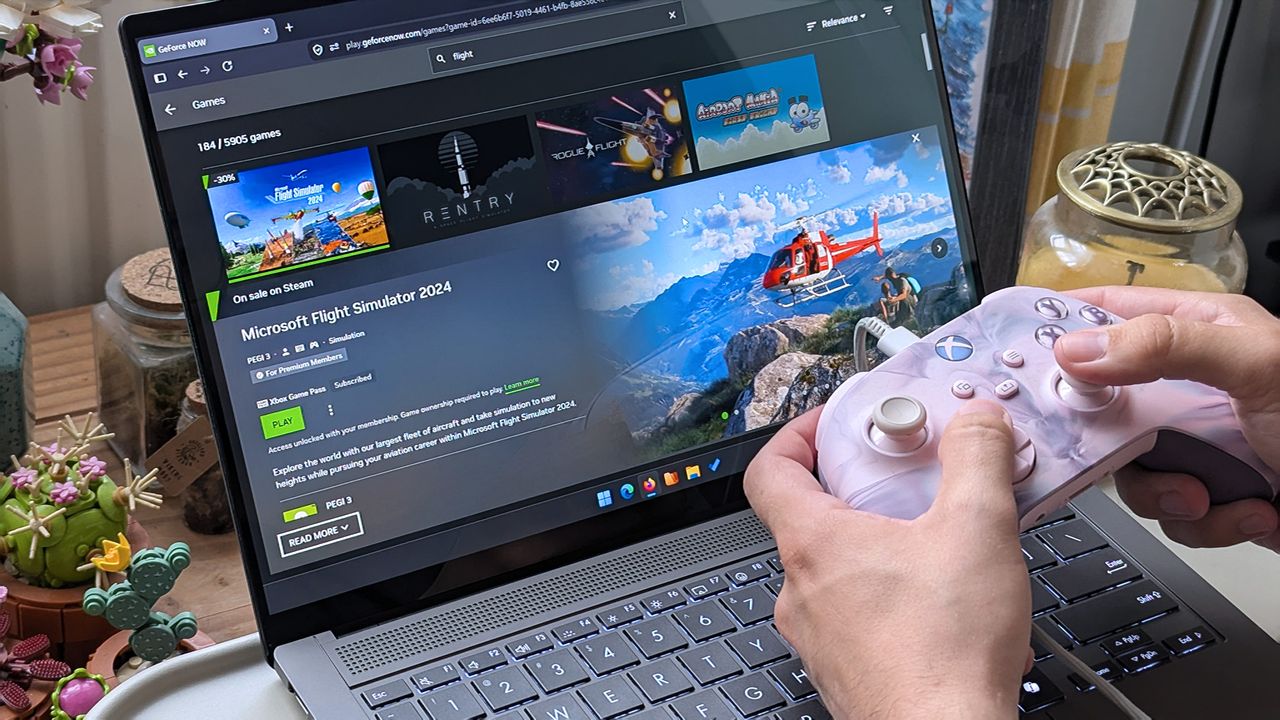
Hands holding a pink‑and‑white Xbox controller in front of an ASUS laptop displaying the GeForce NOW page for Microsoft Flight Simulator 2024, showing a green “Play” button.
GeForce NOW adds official Firefox support, with up to 1440p/120 FPS cloud gaming available to anyone who subscribes to NVIDIA's paid tiers.
I haven't seen a sane GPU price in what feels like almost a year, and the landscape isn't getting any better for gamers.The NVIDIA RTX 5090, which arrived at a $1,999 MSRP in 2025, is now listed at Newegg starting at $4,799.99. The MSI Ventus 3X OC is indeed the lowest price I could find, and there are other options that push well beyond $5,000.Bad luck if you're shopping for a new RTX 5090 alone. The high-end of NVIDIA's consumer GPU stack has become inaccessibl
I haven't seen a sane GPU price in what feels like almost a year, and the landscape isn't getting any better for gamers.
The NVIDIA RTX 5090, which arrived at a $1,999 MSRP in 2025, is now listed at Newegg starting at $4,799.99. The MSI Ventus 3X OC is indeed the lowest price I could find, and there are other options that push well beyond $5,000.
Bad luck if you're shopping for a new RTX 5090 alone. The high-end of NVIDIA's consumer GPU stack has become inaccessible for the average gamer, and there's no real alternative in sight.
Well, that's sort of true. While perusing various storefronts this morning, it quickly became evident that I can buy an entire pre-built gaming PC with an RTX 5090 inside for less than the card alone.
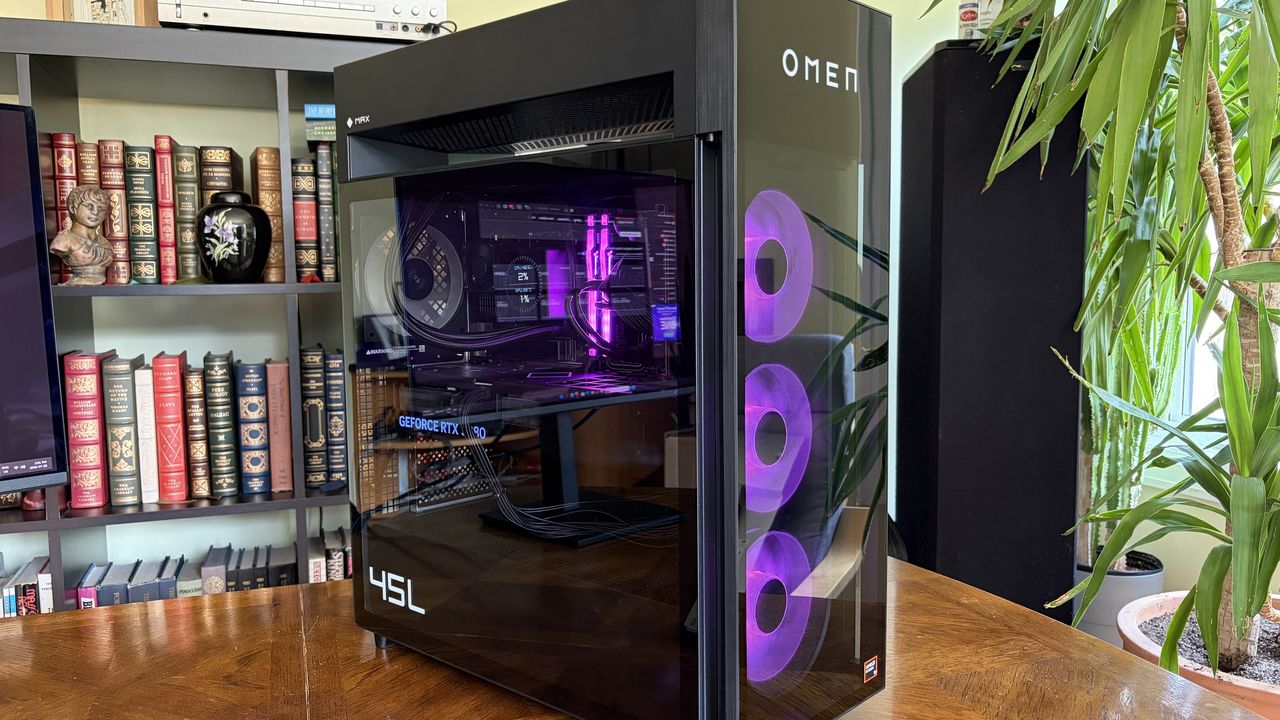
A look at the current promo pricing on a full gaming PC with RTX 5090. (Image credit: HP)
HP's Omen 45L desktop is my prime example. It has an NVIDIA RTX 5090 GPU, an Intel Core Ultra 7 265K CPU, 16GB of DDR5-6000 RAM, a 1TB M.2 PCIe 4.0 NVMe SSD, and everything else you need for a full build.
At the time of writing, this Omen 45L model costs $4,389.99. That's $410 less than the cheapest RTX 5090 listed on Newegg. Of course, the Omen 45L is on sale, with a regular price of $5,379.99. That's still less than the ASUS TUF Gaming RTX 5090 model, which sits at $5,429 on Newegg.
Buy a pre-built gaming PC for the card and sell the rest?
NVIDIA's RTX 5090 has hit costs I never imagined, but there are some alternative options. (Image credit: Windows Central | Ben Wilson)
The math gets more upside down when you factor in all the extra hardware you get with a pre-built PC.
The Omen 45L's CPU adds about $300, the 16GB of Kingston Fury DDR5-6000 RAM adds about $330, and the 1TB M.2 PCIe 4.0 NVMe SSD adds roughly $200. That's about $800 worth of extra components before even considering the 1200W PSU, motherboard, cooling, and case.
I can imagine a lot of readers will see this and wonder why they don't just buy a pre-built, remove the RTX 5090, and sell the rest of the components. I'm wondering the same thing.
HP isn't the only place that I'm seeing this pricing deficit in effect. Over at iBuyPower, I put together a system with an Intel Core i5-14400F CPU, 32GB of DDR5 RAM, a 1TB M.2 PCIe 4.0 NVMe SSD, a 1000W PSU, and an NVIDIA RTX 5090 that costs $5,596.
With the right initiative to sell the extra components, you could definitely end up paying less or the same for a standalone card and still end up with some extra hardware for future upgrades.
The HP Omen Max 45L I reviewed isn't perfect, but if it's cheaper than a lone GPU, it's hard to fault. (Image credit: Future)
The current state of GPU prices is due to the ongoing RAM and storage crisis that's sending NAND, DRAM, and other PC component prices into deep space.
As a result of the VRAM that goes into these cards hitting such high costs, NVIDIA jacked up the prices of GPU kits for its board partners (companies like ASUS, MSI, Gigabyte, and Zotac that build full GPUs using NVIDIA's kit) in July. Shortly after, it was reported that the hike could go as high as 30%.
We're now starting to feel those price hikes at retailers, as evidenced above. I suspect that HP's prices will also eventually be on the rise, but there are different market factors at play.
OEM builders can lock in large supplies of parts at a lower cost, so prices often don't catch up until after regular consumers begin to see them. I saw the same thing happen with Windows laptops this year. Components eventually run out, companies have to buy more, and those new costs are then passed down to consumers.
There's one caveat: when I reviewed the Omen Max 45L, I noticed that the RTX 5080 is a custom unit designed by HP. The same applies to the RTX 5090. Does that really matter? Not really. It's still NVIDIA's GPU inside, and my testing showed no difference compared to standalone cards.
Whatever happens to HP's pre-built PC pricing, there's no denying that the entire PC market is in chaos. You might not love the idea of a pre-built PC, but I definitely recommend seeing what's out there before you buy a standalone RTX GPU. You might just end up with a whole lot more than you expected for a lower price.
Join us on Reddit at r/WindowsCentral to share your insights and discuss our latest news, reviews, and more.
An Omen Max 45L with a transparent side panel displays its internal components, including a GeForce RTX 508 graphics card, against a backdrop of a bookshelf.
An Omen Max 45L with a transparent side panel displays its internal components, including a GeForce RTX 508 graphics card, against a backdrop of a bookshelf.

 Connexion